

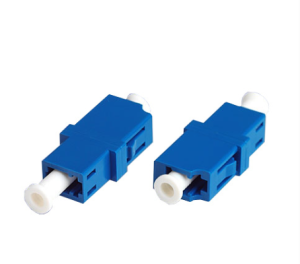
LC-LC 单工光纤耦合器(单工法兰)
特点:单芯独立对接、体积小、可单独布局每一路光纤,适合 BiDi 单纤双向光模块、需要单独管理收发纤的场景,和双工 LC 法兰有明显区别 数据中心机房(高频场景) SFP/SFP+ BiDi 单纤双向光模块链路对接(最常用!BiDi 模块只用 1 根光纤收发,正好匹配单工 LC) ODF 光纤配线架、配线盒内单纤支路的转接、跳线延长 服务器、存储设备、交换机之间的高密度单纤链路,单独管理收、发两根光纤,方便故障定位 40G/100G 光模块拆分为多路单纤链路的配线盒内使用 运营商通信、5G 基站网络 5G 基站前传、中传链路,BBU-RRU 之间单纤链路对接 机房光交箱、综合配线柜、基站远端盒内光纤接续 城域网、传输设备、DWDM
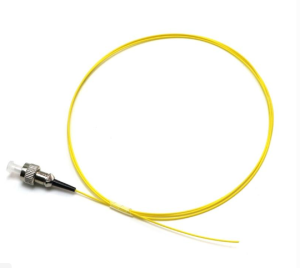
FC/UPC 0.9 尾纤应用场景
核心特点:螺纹锁紧、抗震动、UPC 端面,适合数字光信号;裸纤端熔接光缆,FC 头插法兰 / 设备 运营商机房 ODF 架成端(最常用) 机房主干光缆、出局光缆在熔纤盘内和尾纤裸纤熔接,FC/UPC 头插 ODF 法兰,再跳接传输设备、DWDM 波分、光放、交换机,承载专线、传输环网。 5G 基站 BBU 侧成端(FTTA) 基站机房内,拉远光缆熔接 FC/UPC 尾纤,上 ODF 后接入 BBU 板卡;螺纹锁紧不容易震松,适合长期固定配线。 室外光交箱、楼宇分纤箱、终端盒成端
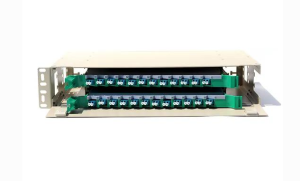
24口48芯ODF光纤配线架
一、基础定义 24 口 48 芯 ODF,属于19 英寸标准机架式光纤配线单元,常规 1U 高度。 这里的 24 口是24 个 LC 双工端口,1 个 LC 双工端口容纳 2 芯光纤,24×2=48 芯,因此叫 24 口 48 芯,是机房常用高密度
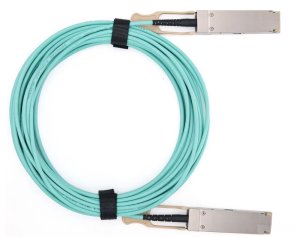
QSFP-100G-AOC 有源光缆
AOC (Active Optical Cables) 有源光缆,是通信过程中依靠供电实现电信号与光信号相互转换的通信线缆,光缆两端的光收发器负责光电转换与光信号传输。 进入大数据时代,高密度、高带宽应用持续增多,无源光缆或铜缆系统逐渐难以满足需求。为保障传输稳定性与使用灵活性,市场急需一种新型传输介质作为高性能计算和数据中心的主力传输载体,有源光缆产品由此应运而生。 相较于传统线缆,有源光缆拥有传输速率高、传输距离远、功耗低、部署便捷等优势,能够使通信设备发挥光传输的性能优势,是数据中心、消费电子等场景理想的高速传输线缆。 随着 “光进铜退” 的发展趋势不可逆转,未来将迈入 “全光网络” 时代,有源光缆技术会逐步渗透到高速互连市场的各个领域。 QSFP-100G-AOC(有源光缆)应用场景 适用范围:1~100 米内,100G 点对点高速互联,优势:即插即用、抗电磁干扰、线缆细、高密度机柜理线友好;适合不想单独采购 SR4 光模块 + MPO 光纤链路的场景 1. 数据中心机房:Leaf-Spine 网络架构(最常用) TOR
AI落地企业:数字化转型的实战指南
AI技术这么火,但你公司真的需要吗?怎么用?用了能带来什么? 不是所有企业都适合做基础大模型,但几乎所有企业都能从AI应用中获益。关键是要选对切入点。 先想清楚:AI能解决什么问题? 很多企业AI项目失败的根因是——根本不知道要解决什么问题。看到别人做了就盲目跟风,结果搞出一堆”PPT项目”。 AI不是万能药,先问自己几个问题: 我现在的业务流程里,哪里最费时间? 哪些决策是重复性的、可以标准化的? 有没有信息检索困难的场景,员工经常找不到资料? 客户服务里有多少问题是重复的? 这些就是AI的用武之地。 企业AI应用的四个层次 第一层是基础工具层。Copilot类助手帮你写文档、做PPT、分析数据。这是门槛最低的,谁都能用,员工生产力直接提升10%-30%。 第二层是流程自动化层。把重复性高、规则明确的工作交给AI。发票处理、合同审核、客服工单分类、数据录入这些,都可以用AI改造。 第三层是决策辅助层。AI不直接做决定,但给决策者提供洞察。销售预测、风险评估、需求预测、舆情分析,这些都是AI擅长的。 第四层是业务重塑层。AI成为产品的一部分,定义新的业务模式。智能客服、智能营销、智能制造、智能医疗……AI不只是工具,是业务核心。 大多数企业应该从第一、第二层入手,逐步往深水区走。一上来就搞”AI重塑业务”容易翻车。 数据:企业AI的真正门槛 模型可以调,算法可以改,但数据是企业独有的资产。AI项目能不能成功,80%取决于数据。 但企业数据现状往往很糟糕:散落在不同系统里,格式不统一,质量参差不齐,存在大量孤岛。 AI落地前要做的数据工作: 数据治理:建立数据标准、明确数据所有权 数据集成:打通各业务系统,建立数据中台 数据清洗:识别和处理脏数据、缺失值 数据标注:为监督学习准备高质量标签数据 没有这步,后续的AI项目都是空中楼阁。
AI大模型训练:千亿参数背后的工程奇迹
GPT-4、Claude、文心一言、通义千问……这些大模型越来越像科幻。但你知道训练一个千亿参数模型是什么概念吗? 这是一个工程奇迹,也是一场算力军备竞赛。 大模型到底有多大? GPT-3是1750亿参数,GPT-4据传超过1.8万亿。模型不是越大越好,但更大的模型确实能涌现出意想不到的能力——逻辑推理、代码生成、多语言理解,这些能力往往只在参数规模达到一定量级后才会出现。 但参数多意味着什么?1.8万亿个参数,每个用16位浮点数存,就需要360GB内存。这还只是存模型。训练时还要存梯度、优化器状态、激活值……实际显存需求是参数量的十几倍。 训练需要多少算力? 训练GPT-3级别的模型,用上千块顶级GPU跑几个月是基本操作。Meta训练LLaMA用了2048块A100 GPU,跑了几周。 这块算力成本巨大:A100单卡几万人民币,顶级AI集群动辄几亿。再加上电力消耗——训练一个模型用掉几百万度电是很常见的。 并行训练:把大象装进冰箱 怎么训练一个超大的模型?核心思路是”分而治之”,业界主要用三种并行策略: 数据并行:把数据切成多份,每块GPU跑相同的模型但喂不同数据。简单粗暴,但每张卡都得存完整的模型,对显存要求高。 模型并行:把模型切成多份,分到不同GPU上。每张卡只负责模型的一部分,但GPU之间需要频繁通信。 流水线并行:把模型按层分,不同层在不同GPU上,像流水线一样工作。通信开销小但需要仔细调度。 实际项目里,这三种往往组合使用——3D并行。 数据:被低估的关键 聊大模型时大家总盯着参数规模和算力,但数据质量才是决定模型上限的关键。 数据清洗不是简单地”去重去脏”。你需要: 质量过滤:把低质量、垃圾信息过滤掉 去重:减少重复样本,避免模型”背诵”而不是”理解” 去偏见:识别和缓解数据中的偏见 多样化:覆盖不同领域、不同语言、不同文化 现在业界共识是:数据质量>数据数量。一个用1万亿精选token训练的小模型,往往比用10万亿杂乱token训练的大模型表现更好。 优化训练的实用技术 训练千亿模型不只是堆GPU,还有很多工程优化: