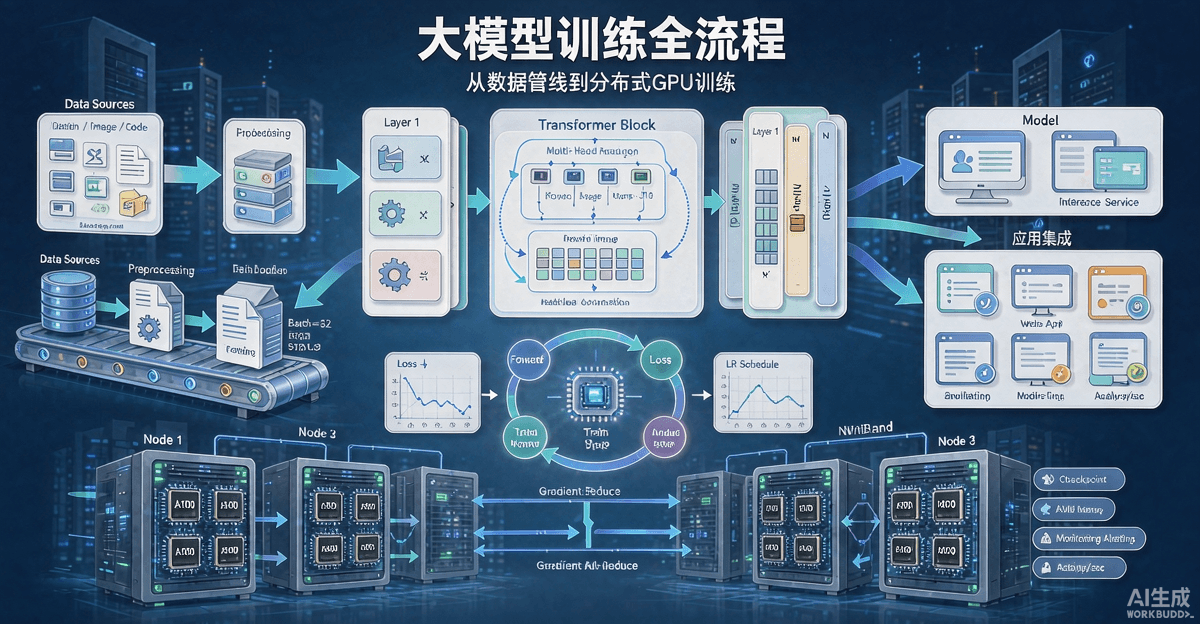
GPT-4、Claude、文心一言、通义千问……这些大模型越来越像科幻。但你知道训练一个千亿参数模型是什么概念吗?
这是一个工程奇迹,也是一场算力军备竞赛。
大模型到底有多大?
GPT-3是1750亿参数,GPT-4据传超过1.8万亿。模型不是越大越好,但更大的模型确实能涌现出意想不到的能力——逻辑推理、代码生成、多语言理解,这些能力往往只在参数规模达到一定量级后才会出现。
但参数多意味着什么?1.8万亿个参数,每个用16位浮点数存,就需要360GB内存。这还只是存模型。训练时还要存梯度、优化器状态、激活值……实际显存需求是参数量的十几倍。
训练需要多少算力?
训练GPT-3级别的模型,用上千块顶级GPU跑几个月是基本操作。Meta训练LLaMA用了2048块A100 GPU,跑了几周。
这块算力成本巨大:A100单卡几万人民币,顶级AI集群动辄几亿。再加上电力消耗——训练一个模型用掉几百万度电是很常见的。
并行训练:把大象装进冰箱
怎么训练一个超大的模型?核心思路是”分而治之”,业界主要用三种并行策略:
数据并行:把数据切成多份,每块GPU跑相同的模型但喂不同数据。简单粗暴,但每张卡都得存完整的模型,对显存要求高。
模型并行:把模型切成多份,分到不同GPU上。每张卡只负责模型的一部分,但GPU之间需要频繁通信。
流水线并行:把模型按层分,不同层在不同GPU上,像流水线一样工作。通信开销小但需要仔细调度。
实际项目里,这三种往往组合使用——3D并行。
数据:被低估的关键
聊大模型时大家总盯着参数规模和算力,但数据质量才是决定模型上限的关键。
数据清洗不是简单地”去重去脏”。你需要:
- 质量过滤:把低质量、垃圾信息过滤掉
- 去重:减少重复样本,避免模型”背诵”而不是”理解”
- 去偏见:识别和缓解数据中的偏见
- 多样化:覆盖不同领域、不同语言、不同文化
现在业界共识是:数据质量>数据数量。一个用1万亿精选token训练的小模型,往往比用10万亿杂乱token训练的大模型表现更好。
优化训练的实用技术
训练千亿模型不只是堆GPU,还有很多工程优化:
混合精度训练:用FP16或BF16代替FP32,显存减半,速度翻倍,对精度影响可控。
梯度累积:用小batch跑几次再更新一次参数,模拟大batch效果。
检查点:每训练一段时间就保存一次,避免一次故障前功尽弃——训练几周的模型崩了那可要命。
弹性训练:某个节点故障不影响整体训练,资源池自动调度补充。
分布式训练的硬件挑战
训练集群对网络要求极高。GPU之间需要频繁交换梯度数据,延迟和带宽直接决定训练效率。
现在主流方案是:
- 节点内:NVLink/NVSwitch,900GB/s带宽
- 节点间:InfiniBand或RoCE,400Gbps起步
- 存储:并行文件系统,GB/s级吞吐
这就是为什么我们说AI时代光纤基础设施是”隐形支柱”——没有它,GPU就是昂贵的取暖器。
展望:训练效率还会提升
虽然模型越来越大,但训练效率也在指数级提升。Meta的数据显示,他们训练一个同等能力模型用的算力每年减少到原来的1/3到1/4。
新架构、新算法、新硬件都在推动这个进程。MoE(混合专家)架构、FlashAttention、Speculative Decoding……每一项突破都在重新定义”大模型训练”的可能性。
大模型训练不是简单的”堆GPU”,而是一个系统工程。理解这一点,才能在AI浪潮中站稳脚跟。